先找到正确的原始年报
模型只负责提取公司、股票代码和年份;公告检索与 PDF 下载由巨潮资讯 API 完成,确保分析基于正式披露文件。
AGENT PLATFORM · SIEMENS · 2026
把分散的 Agent、Workflow 与知识库收敛为统一入口,让团队成员无需理解底层基础设施即可复用 AI 能力。
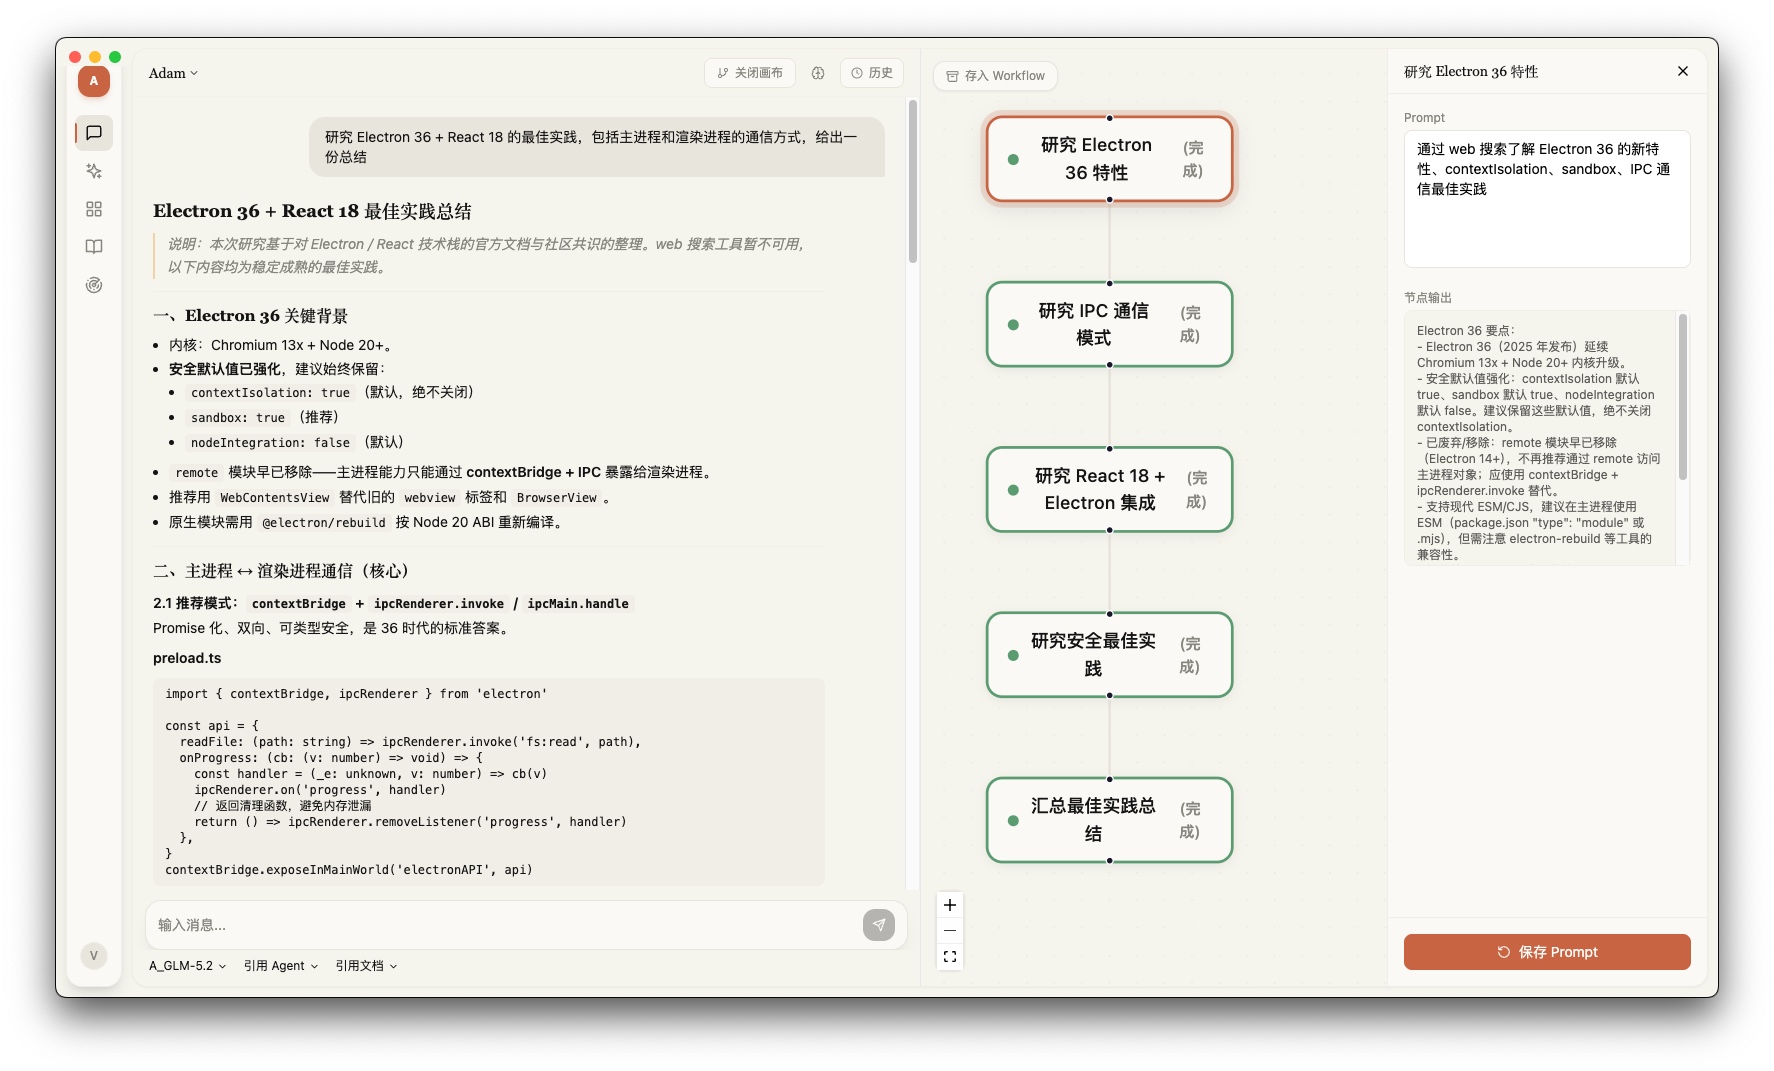
能力证明:把 Agent 的意图识别、工具编排与执行链路收敛为可视化、可复用的工作流。
模型只负责提取公司、股票代码和年份;公告检索与 PDF 下载由巨潮资讯 API 完成,确保分析基于正式披露文件。
PyMuPDF 提取全文后,程序定位 MD&A 与财务报告章节,分别完成文本清洗和三大报表结构化,减少模型输入噪声。
单公司分析先独立完成,再聚合为跨公司、跨年度比较,最终输出可浏览的 HTML 与可继续编辑的 DOCX 报告。
flowchart LR
    U["当前用户输入"] --> R{"运行模式"}
    H["当前会话完整历史"] --> R
    M["长期用户记忆"] --> D["默认 Adam"]
    K["引用文档 / DB 内容"] --> R
    S["Agent System Prompt"] --> N["Native Agent"]

    R --> D
    R --> N
    R --> W["复杂任务 Workflow"]
    R --> E["Eve 编码模式"]

    D --> L["LLM messages[]"]
    N --> L
    W --> P["拆解独立 Worker Prompt"]
    P --> X["上游结果注入"]
    X --> Y["最终综合"]
    E --> O["JSON 结构化操作"]
    O --> G["本地受控文件操作"]

    L --> IPC["Electron IPC"]
    IPC --> PI["pi-ai"]
    PI --> API["OpenAI-compatible API"]
当前输入、完整会话历史和引用文档会按运行模式组装;系统提示词提供 Agent 的角色、边界与工具约束。
会话历史负责眼前任务的连续性,长期用户记忆负责稳定偏好与跨会话信息;只有与本次任务相关的内容才进入模型上下文。
普通回答进入 messages[];复杂任务拆给 Worker 后综合;Eve 则先生成 JSON 操作,再通过权限边界执行本地文件变更。
先按用户、Agent、Run 与元数据缩小范围,再结合向量语义、BM25 关键词、实体和时间信号完成召回与排序。
排序后的少量记忆与当前问题、对话历史一起注入模型,让回答获得跨会话连续性,同时控制上下文长度与噪声。
模型从用户消息和助手回答中提取稳定事实,过滤闲聊与一次性信息,再写入历史、向量数据库和实体关联。
sequenceDiagram
    participant U as 用户
    participant F as 前端
    participant A as FastAPI Agent
    participant L as 大模型
    participant T as query_category_prices
    participant C as 云厂商 API

    U->>F: 计算型云服务哪家便宜?
    F->>A: POST /api/agent/chat
    A->>L: System + History + User + Tools
    L-->>A: tool_call(category="compute")
    A->>T: query_category("compute")
    T->>C: 并发查询 Azure/AWS/阿里云
    C-->>T: 结构化价格数据
    T-->>A: prices[]
    A->>L: role=tool + prices JSON
    L-->>A: 基于真实数据生成对比建议
    A-->>F: SSE 流式 Token + 价格表
    F-->>U: 展示回答
FastAPI 把 System、History、User 与工具定义一起交给模型;识别到计算型需求后,模型只返回带品类参数的 tool call。
价格工具并发请求 Azure、AWS 与阿里云接口,把厂商字段转换成一致的 prices[],再以 role=tool 的结构化结果注回模型。
第二次模型调用只基于真实数据生成对比建议;SSE 持续推送 Token,并把结构化价格表交给前端稳定展示。